
H200 vs H100:升级点在哪,值不值得换代
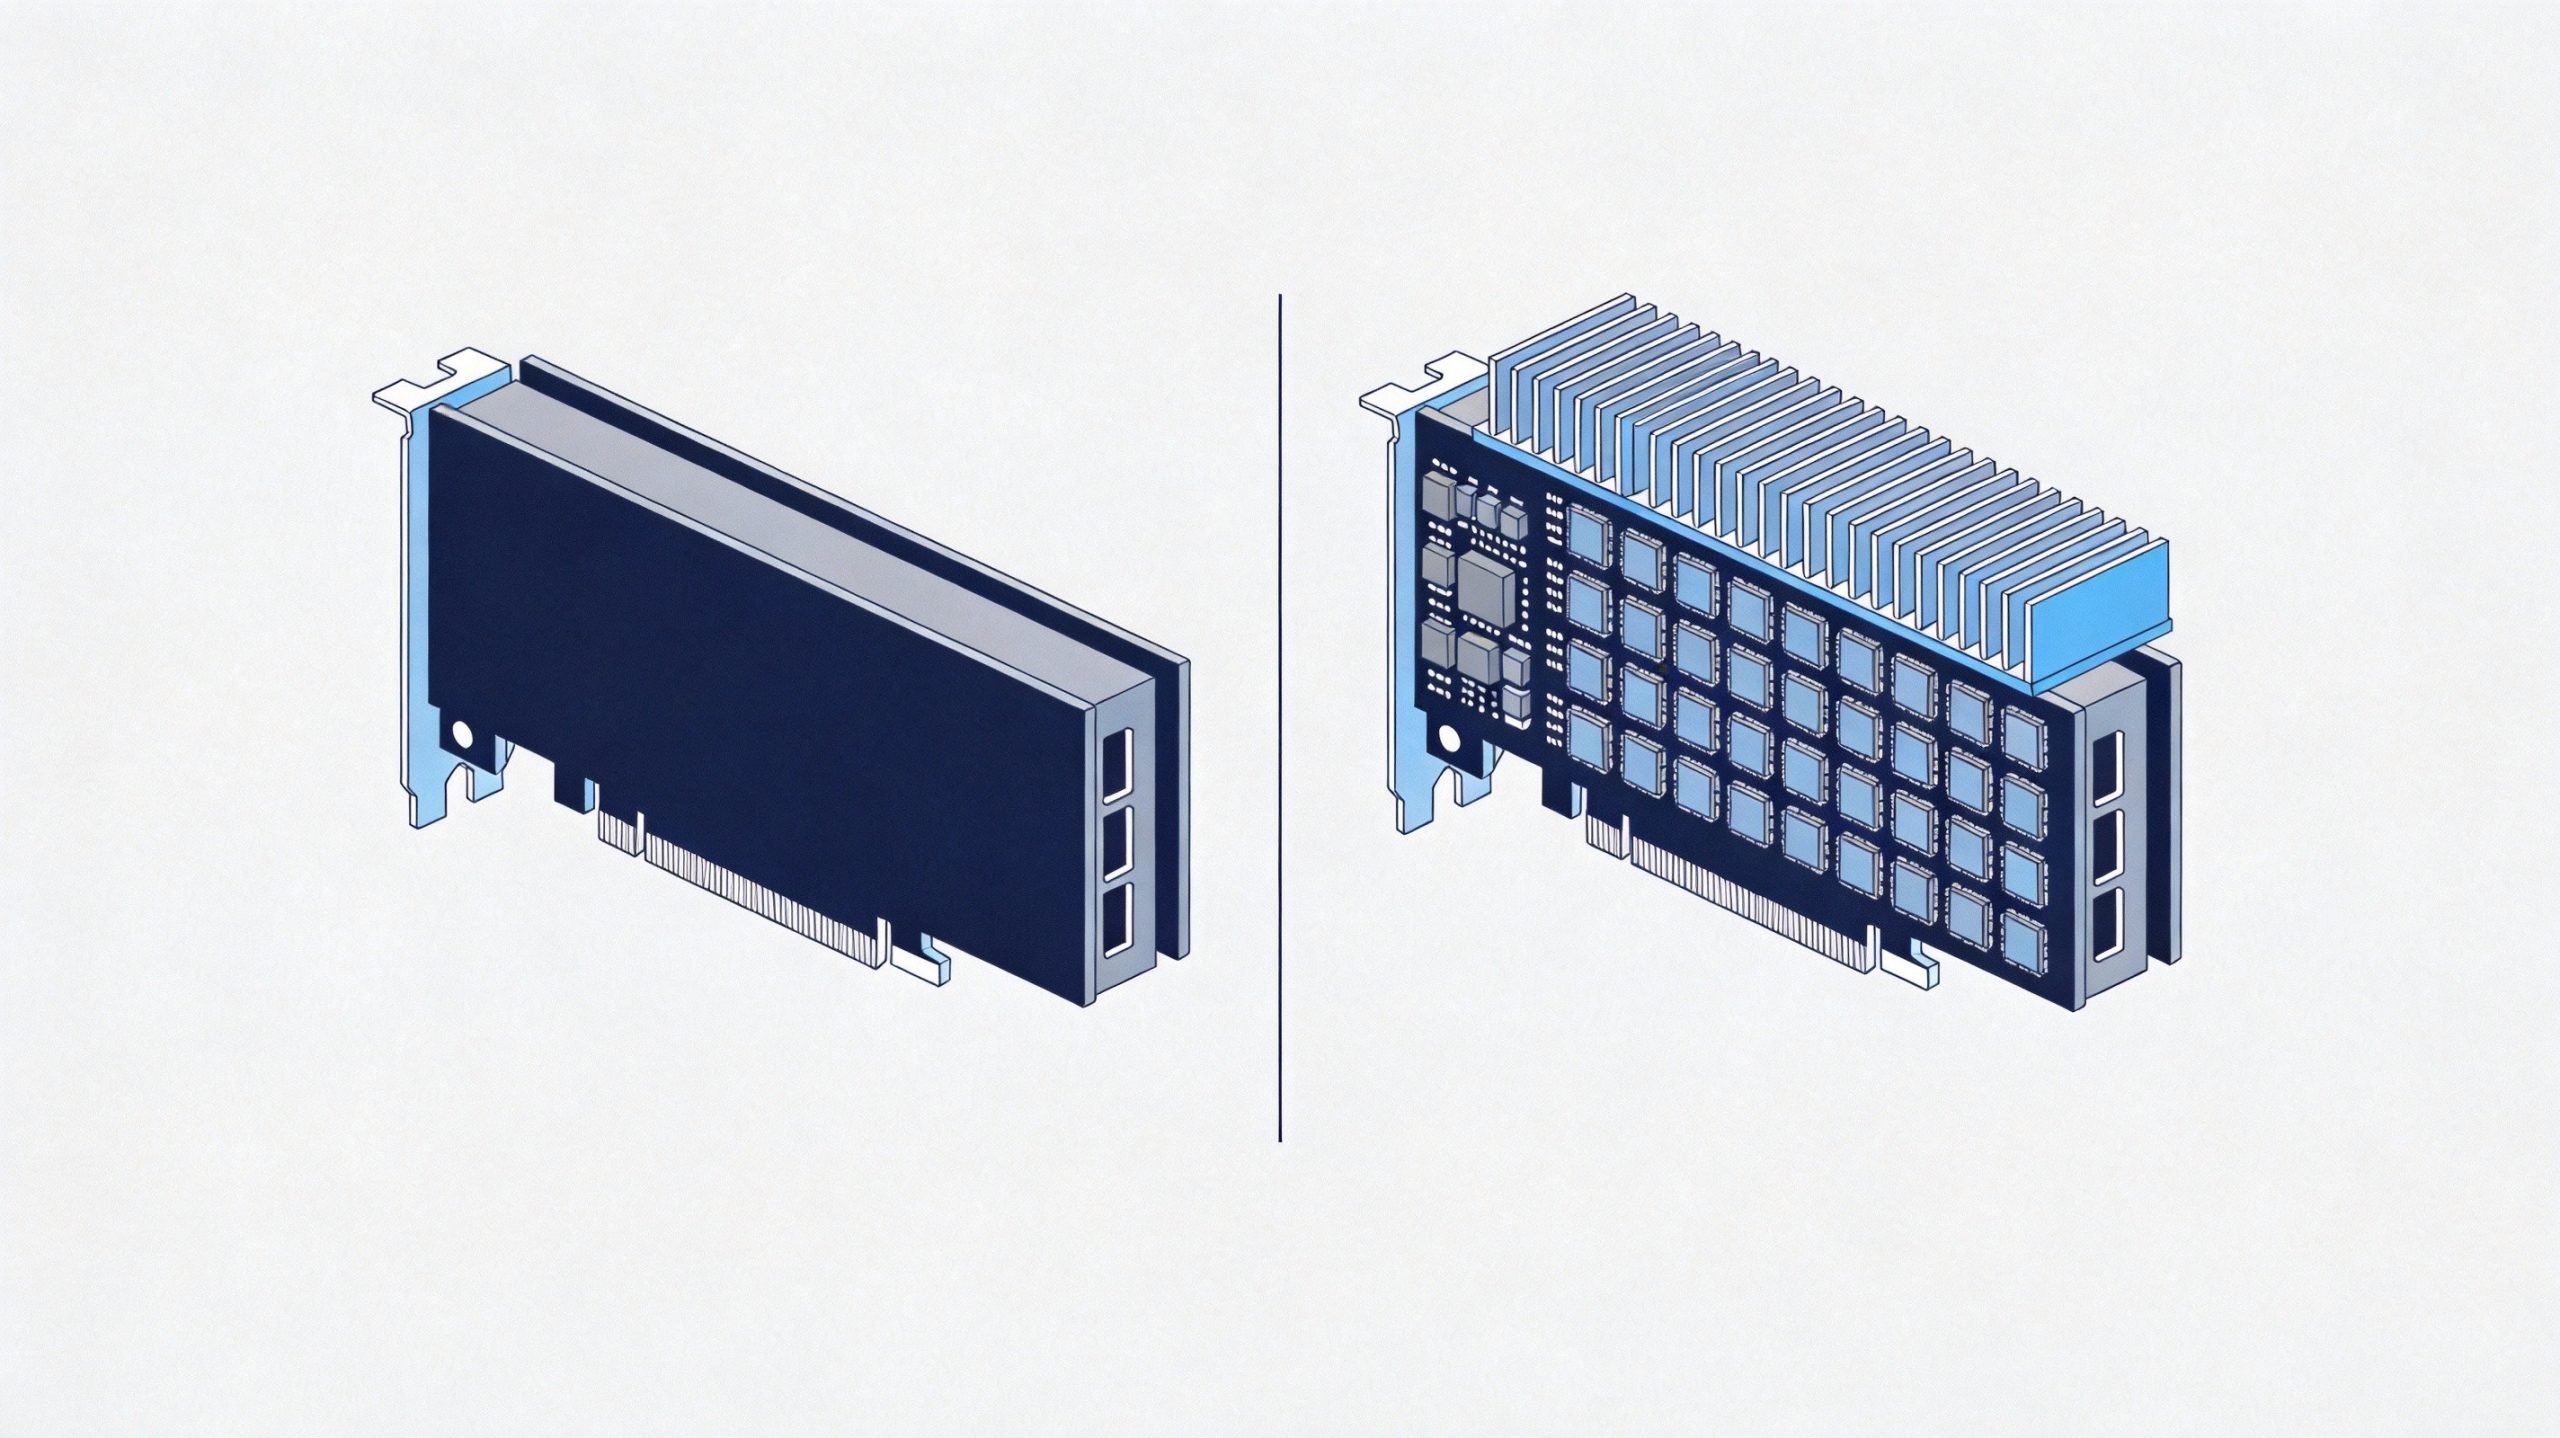
手里有 H100 的团队,最常问的一个问题是:要不要换 H200。答案取决于你卡在哪个环节。
真正的升级点只有两个
H200 和 H100 用的是同一代 Hopper 计算核心,CUDA 核心数量、Tensor Core 架构基本一致。差别集中在显存子系统:
一是容量,从 80GB 提到 141GB,涨了约七成;二是带宽,从 3.35TB/s 提到 4.8TB/s,涨了约四成。
别小看这两个数字。大模型推理的瓶颈往往不在算力,而在显存带宽和数据搬运。显存够大,模型不用切分;带宽够高,权重加载更快。NVIDIA 官方公布的对比里,H200 在部分大模型推理场景下相对 H100 有接近翻倍的吞吐提升,来源正是这两项改进。
什么情况值得换
模型装不下,是最直接的理由。70B 级别的模型做长上下文推理,80GB 显存往往要拆到多卡,通信开销吃掉不少性能;141GB 单卡能装下更多,部署密度立刻改善。
推理成本压不下来,是第二个理由。单卡能服务的并发更高,单位 token 成本就下来了。业务量大的团队,这笔账算得很清楚。
训练侧则要看具体规模。中小规模微调,H100 集群往往够用;参数规模继续往上走,显存和带宽的价值才会凸显。
什么情况可以先不换
现有集群利用率本来就不高,换卡只是把闲置资源换成更贵的闲置资源。
业务对延迟不敏感、对成本敏感,H100 的性价比可能更好。
机房供电和散热没做好,上了 H200 也跑不满——单卡功耗到 700W 量级,整机功率密度更高,基础设施跟不上,换卡等于白花钱。
换代的现实路径
不必一次性全换。常见做法是新业务直接上 H200,老集群继续承载成熟业务,等折旧周期走完再逐步替换。也可以用租用方式先验证 H200 在自家模型上的实际收益,跑出数据再决定采购。
中海云算同时提供 H100 与 H200 算力服务器,可以先小规模试跑对比,用真实业务数据做决策,比看参数表靠谱得多。

qcyun
暂无介绍....
141GB显存能解决什么问题
延伸阅读:
云服务器账单越滚越大,先查这三类闲置资源
云上成本失控,很少是因为单价高,更多是因为资源被遗忘。项目上线时开的一批测试机、做活动临时扩的实例、迁移后没释放的旧主机...

云服务器弹性伸缩配不好,扩容反而会拖垮业务
流量曲线从来不是平的。早高峰、午间小高峰、晚间活动和突发热点,都会让一台固定规格的云服务器在某个时刻被压到CPU满载。很...
云服务器备份别靠运气:快照、镜像与恢复演练该怎么做
很多团队对云服务器备份的理解,还停留在控制台里点一下快照。直到某天误删了数据库目录、被勒索软件加密了整块系统盘,或者所在...
云服务器带宽怎么买?固定带宽与按流量计费的临界点算给你看
云服务器账单里最容易失控的一项往往不是CPU,而是带宽。买固定带宽吧,平时用不到一半,钱照付;改成按流量计费吧,一篇稿子...
云服务器云盘怎么选?普通云盘、SSD云盘、ESSD的IOPS差距与选盘策略
数据库慢查询排查了一圈,索引加了、SQL改了、连接池也调了,响应时间还是卡在两百毫秒下不来,最后发现是云盘的IOPS被打...